
O que é CI/CD? Entenda a esteira antes do GitHub Actions
Entenda integração contínua, entrega contínua e deployment contínuo antes das ferramentas, e veja como testes, build, artefatos e deploy formam a esteira.

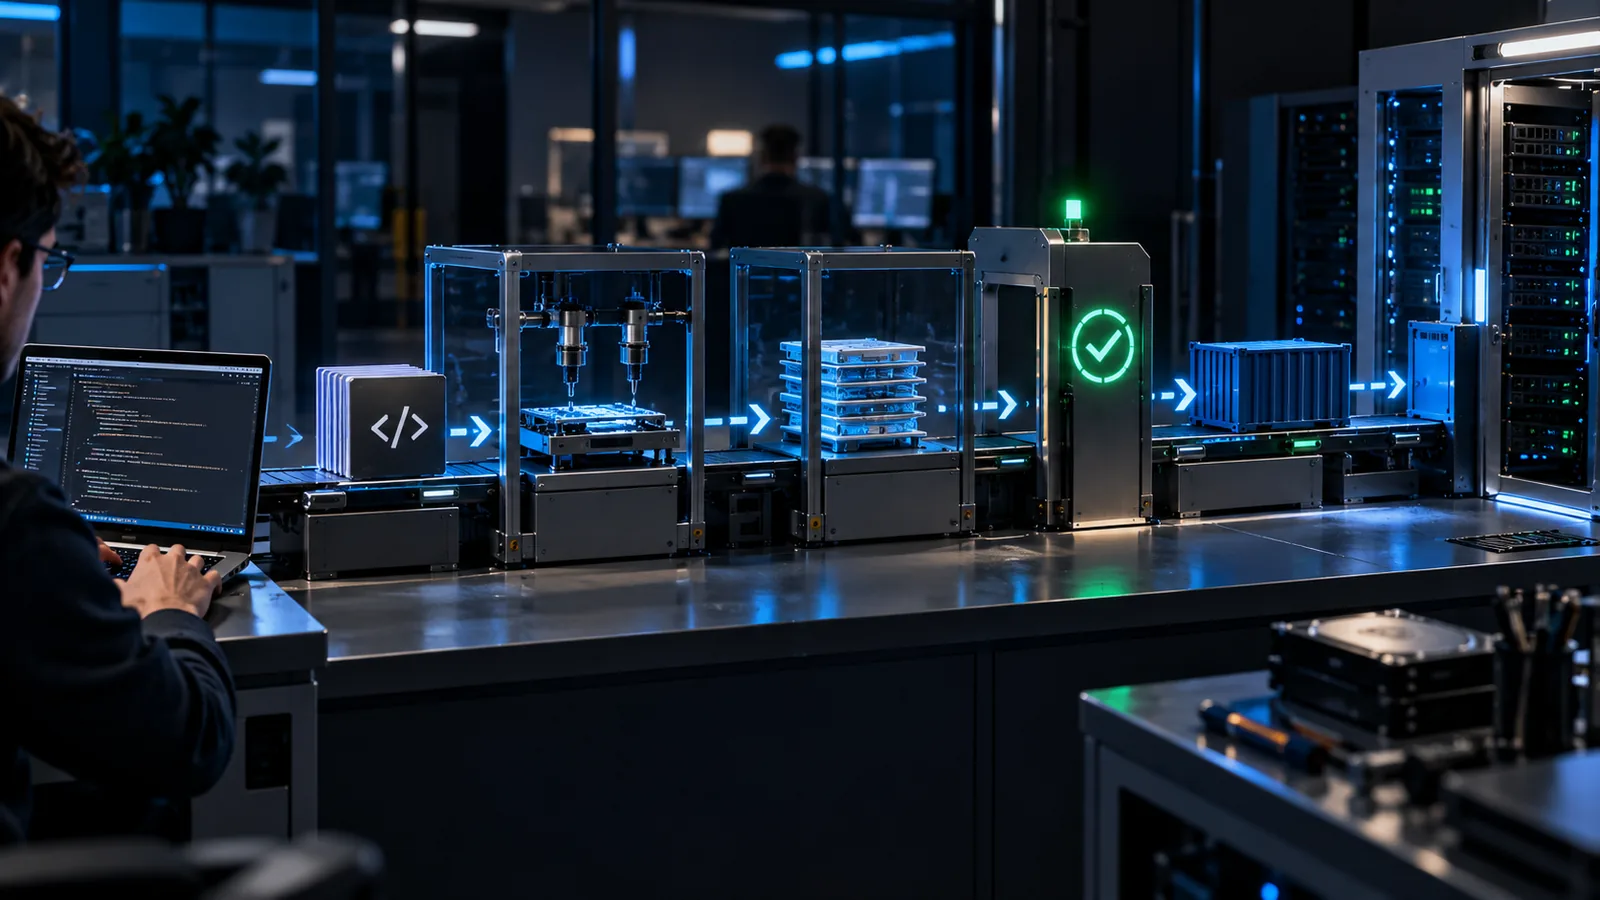
Se você já viu um arquivo em .github/workflows/, um painel com jobs verdes e vermelhos ou um pipeline com etapas como test, build e deploy, já encontrou uma implementação de CI/CD.
O problema é começar pela ferramenta. Quando isso acontece, CI/CD parece apenas uma coleção de arquivos YAML e comandos automáticos.
O conceito é mais útil quando começamos pela pergunta anterior:
como uma equipe transforma mudanças frequentes de código em software integrável, verificável e pronto para ser entregue com segurança?
CI/CD organiza essa resposta.
CI/CD não é uma única coisa
A sigla reúne práticas relacionadas, mas diferentes.
CI, de Continuous Integration, é integração contínua: integrar mudanças ao código compartilhado com frequência e verificar essas integrações rapidamente por meio de automação.
CD pode aparecer em dois sentidos diferentes:
- Continuous Delivery: entrega contínua — manter o software em estado deployable e permitir que uma versão seja liberada sob demanda de forma confiável;
- Continuous Deployment: deployment contínuo — promover automaticamente para produção as mudanças que passam pelos critérios definidos.
Essas duas ideias não são equivalentes.
Uma equipe pode praticar continuous delivery e ainda exigir uma decisão humana para publicar em produção. Continuous deployment remove esse último passo manual conforme a política adotada.
O fluxo mental da esteira
Uma representação simplificada pode ser:
commit
  ↓
integração
  ↓
lint + testes + segurança
  ↓
build
  ↓
artefato
  ↓
gate
  ↓
deploy
  ↓
healthcheck + observabilidade
Nem todo projeto terá exatamente essas etapas, e algumas podem acontecer em paralelo. O valor do modelo está em enxergar as fronteiras.
O commit introduz uma mudança. A integração coloca essa mudança em contato com o restante do código. As verificações tentam descobrir problemas cedo. O build produz algo versionável. O artefato pode ser promovido entre ambientes. Um gate decide se a mudança pode avançar. O deploy coloca a versão no ambiente. Depois vêm as verificações que dizem se a versão realmente se comporta como esperado.
Um pipeline é, portanto, uma forma executável de representar parte desse processo.
Ele não é o objetivo final. É o mecanismo que transforma regras de qualidade e entrega em passos repetíveis.
Integração contínua reduz o tamanho do problema
Imagine três desenvolvedores trabalhando durante duas semanas em branches longas. Cada um muda estruturas, dependências e contratos diferentes. Quando chega o momento de juntar tudo, os conflitos não estão apenas no Git: eles aparecem no comportamento do sistema.
CI tenta encurtar esse intervalo.
A prática pressupõe integração frequente ao repositório compartilhado e feedback rápido quando alguma mudança quebra o build, os testes ou outra regra importante.
Esse ponto é mais importante que a ferramenta usada. Você pode executar CI com GitHub Actions, GitLab CI, Jenkins, CircleCI, Buildkite ou outra plataforma. O princípio continua sendo integrar cedo e detectar regressões enquanto a mudança ainda é pequena e recente.
Em uma esteira de CI, verificações comuns incluem:
- lint e formatação;
- testes unitários;
- testes de integração;
- análise estática;
- verificação de tipos;
- análise de dependências e segurança;
- cobertura ou outros critérios específicos do projeto;
- construção de um artefato reproduzível.
Nem toda checagem precisa existir em todo projeto. O conjunto deve refletir os riscos reais do sistema.
O que importa é evitar um pipeline decorativo: muitos jobs verdes que não validam aquilo que realmente costuma quebrar.
Continuous delivery mantém o software pronto para avançar
Continuous delivery amplia o problema. Não basta integrar código com frequência; o sistema precisa permanecer em condição de ser entregue com segurança quando necessário.
Isso exige mais do que um job de teste. A capacidade de delivery depende de práticas que mantêm build, ambientes, banco de dados, configuração, segurança e deploy sob controle.
Uma consequência importante é tratar falha no pipeline como sinal operacional relevante. Se a branch principal deixa de estar deployable, continuar acumulando novas mudanças aumenta o problema que precisará ser resolvido depois.
Por isso, uma equipe madura tenta restaurar rapidamente o estado saudável da esteira.
Continuous delivery também favorece mudanças menores. Quando dezenas de funcionalidades e correções são empacotadas em uma única release gigantesca, fica mais difícil identificar causa, validar impacto e reverter com segurança.
Pequenas mudanças não eliminam risco, mas reduzem a quantidade de coisas que podem ter causado um problema.
Continuous deployment adiciona automação da promoção
Continuous deployment vai um passo além: quando a mudança passa pelos critérios definidos, o processo pode promover a versão automaticamente até produção.
Isso não significa "qualquer commit vai para produção sem controle".
Os controles continuam existindo; o que muda é onde eles estão. Testes, políticas, aprovações automatizadas, análise de segurança, progressive delivery e outros gates podem decidir se a mudança avança.
Em sistemas nos quais deployment contínuo não faz sentido — por requisito regulatório, característica do produto, distribuição física ou decisão de negócio — continuous delivery ainda é plenamente útil.
A pergunta correta não é "tem botão manual, então não é CI/CD?". É entender qual nível de automação e qual política de promoção aquele sistema realmente precisa.
Build e artefato dão identidade à versão
Uma esteira confiável precisa saber o que está promovendo.
O build pode gerar um binário, pacote, bundle, imagem de container ou outro artefato. Esse artefato deve ser identificável e rastreável até o código que o originou.
Quando o mesmo artefato aprovado é promovido entre ambientes, diminui o risco de reconstruir uma versão diferente para produção.
A esteira pode registrar, por exemplo:
- SHA do commit;
- número da versão;
- digest da imagem;
- resultado dos testes;
- dependências relevantes;
- ambiente de destino;
- horário e executor da promoção.
Isso transforma "a última versão" em algo verificável.
Gates existem para impedir avanço indevido
Nem toda etapa precisa avançar automaticamente.
Um gate é um critério que precisa ser satisfeito antes da próxima promoção. Pode ser automatizado ou exigir decisão humana.
Exemplos:
- testes obrigatórios passando;
- revisão aprovada;
- vulnerabilidade crítica ausente;
- migração validada;
- aprovação para produção;
- janela operacional específica;
- canário dentro dos limites esperados.
Um gate útil representa uma regra real de risco. Um gate burocrático que sempre é aprovado sem evidência só adiciona atraso.
Pipeline verde não significa produção saudável
Esse é um dos limites mais importantes do CI/CD.
O pipeline consegue provar apenas aquilo que ele realmente mede. Se os testes não cobrem determinado comportamento, um job verde não cria essa garantia por mágica.
Depois do deploy ainda podem surgir problemas como:
- configuração incorreta do ambiente;
- dependência externa indisponível;
- migração de banco com efeito inesperado;
- aumento de latência;
- erro que só aparece com tráfego real;
- fila acumulando;
- consumo excessivo de CPU ou memória;
- falha específica de um segmento de usuários.
Por isso a esteira de entrega precisa conversar com healthchecks e observabilidade.
O pipeline responde bem a perguntas como "os critérios que definimos foram satisfeitos?". A produção acrescenta outra pergunta: "o sistema real continua entregando o comportamento esperado?".
Uma operação madura conecta as duas coisas. Se a versão degrada logo depois da implantação, métricas, traces, logs ou alertas podem interromper a expansão do rollout ou acionar rollback.
Healthcheck e rollback fazem parte da conversa
Um healthcheck pode impedir que tráfego seja enviado para uma instância que ainda não está pronta. Ele também pode tornar um deploy automatizado mais confiável ao oferecer um sinal objetivo de readiness.
Mas healthcheck não é observabilidade completa. Ele testa uma capacidade específica.
Rollback, por sua vez, precisa ser pensado antes do incidente. Se o pipeline sabe implantar mas ninguém sabe retornar para uma versão segura, a automação resolveu apenas metade do problema.
Esses pontos conectam CI/CD à engenharia operacional: entregar software não termina quando o job de deploy fica verde.
Onde o GitHub Actions entra
GitHub Actions é uma plataforma capaz de executar workflows de CI/CD a partir de eventos do repositório. Um push, pull request, agenda ou acionamento manual pode iniciar jobs em runners hospedados pelo GitHub ou em máquinas administradas pela própria equipe.
Isso é uma implementação do modelo, não o modelo em si.
Um workflow poderia representar algo como:
pull request
  ↓
lint + testes
  ↓
merge
  ↓
build da imagem
  ↓
registro do artefato
  ↓
deploy em staging
  ↓
smoke test
  ↓
aprovação
  ↓
produção
GitLab CI, Jenkins, CircleCI e outras ferramentas podem implementar uma sequência equivalente com sintaxe e arquitetura diferentes.
Por isso, aprender apenas onde colocar uses: ou run: em YAML cria uma habilidade frágil. Entender por que cada etapa existe permite migrar de ferramenta sem perder o raciocínio.
Runner é infraestrutura da esteira
Toda automação precisa executar em algum lugar.
No GitHub Actions, o runner é a máquina ou ambiente que recebe o job e executa seus passos. Pode ser hospedado pelo GitHub ou self-hosted.
Quando você opera runners próprios, a responsabilidade aumenta: versão do runner, sistema operacional, ferramentas instaladas, capacidade, segurança, conectividade, atualizações e observabilidade passam a fazer parte da confiabilidade do CI/CD.
Esse é justamente o próximo aprofundamento operacional do tema. No artigo GitHub Actions self-hosted runner: como evitar que seus workflows parem em setembro de 2026, a discussão sai do conceito e entra na operação real de runners, atualização e continuidade da esteira.
O que CI/CD não resolve sozinho
Automação não corrige um processo mal desenhado por conta própria.
Você pode ter um pipeline sofisticado e ainda sofrer com branches longas, testes frágeis, arquitetura difícil de implantar, dependências manuais, ambientes inconsistentes e releases enormes.
Também é possível cair no extremo oposto: transformar o pipeline em uma sequência tão lenta e instável que a equipe começa a contorná-lo.
CI/CD funciona melhor quando o feedback é confiável e rápido o suficiente para fazer parte do fluxo diário.
Isso exige manutenção. Testes quebrados precisam ser corrigidos. Dependências precisam ser atualizadas. Runners precisam permanecer saudáveis. Credenciais precisam expirar e ser renovadas de forma segura. Métricas da própria esteira podem revelar filas, gargalos e etapas excessivamente lentas.
A pipeline é software de infraestrutura. Ela também precisa de engenharia.
Como observar CI/CD em um projeto real
Pegue um repositório que você usa e responda às perguntas abaixo:
- o que acontece quando alguém abre um pull request?
- quais verificações bloqueiam merge?
- qual artefato representa uma versão aprovada?
- como esse artefato chega ao ambiente seguinte?
- quem ou o que autoriza produção?
- como o sistema verifica a nova versão após o deploy?
- como a equipe descobre rapidamente que produção degradou?
- qual é o caminho de rollback?
Se o projeto só possui um script que copia arquivos para o servidor, existe automação de deploy, mas talvez ainda não exista uma esteira de CI/CD madura.
Se possui dezenas de jobs mas ninguém consegue explicar qual risco cada um controla, existe complexidade, não necessariamente confiabilidade.
Uma esteira útil cria feedback, não só automação
O valor mais importante de CI/CD é reduzir o tempo entre uma mudança e a descoberta de que algo está errado.
Quanto mais cedo o problema aparece, menor costuma ser o contexto necessário para investigá-lo. Uma falha detectada minutos depois de um commit é diferente de uma regressão descoberta semanas depois, misturada a dezenas de outras mudanças.
Por isso, a esteira não deveria ser vista apenas como "robô que faz deploy". Ela é parte do sistema de feedback da engenharia.
mudança
  ↓
verificação
  ↓
feedback
  ↓
correção ou promoção
  ↓
observação em ambiente real
  ↺
Essa última volta do ciclo prepara o próximo conceito da jornada: observabilidade.
CI/CD consegue automatizar verificações conhecidas e promoção de versões. Observabilidade ajuda a responder o que está acontecendo quando o sistema real apresenta comportamento que você não previu completamente no pipeline.
Entender essa fronteira evita duas expectativas erradas: achar que CI/CD termina na configuração de uma ferramenta e achar que um pipeline verde prova, sozinho, a saúde da produção.