
Cloud: regiões, zonas, redes, DNS e load balancer sem decorar um provedor
Entenda regiões, zonas de disponibilidade, redes virtuais, endereços públicos e privados, DNS, ingress, egress, NAT e load balancers em AWS, Google Cloud e Azure por conceitos transferíveis.

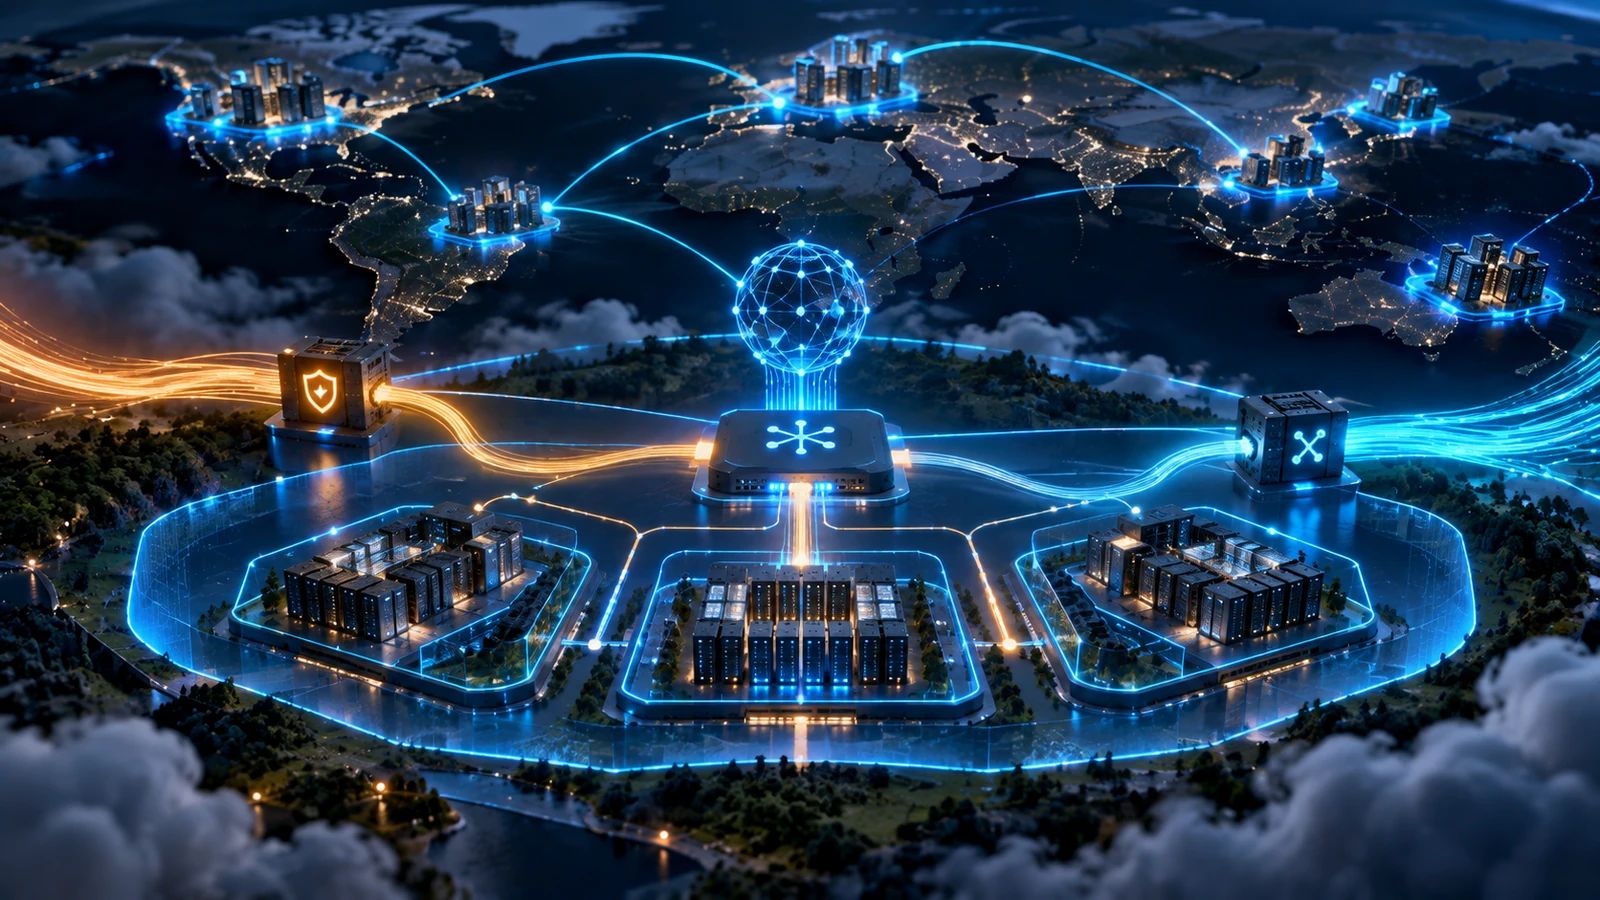
Cloud não existe em um lugar abstrato chamado “a nuvem”.
Recursos são implantados em localidades reais, conectados por redes reais e sujeitos a domínios de falha reais.
Quando você escolhe uma região, uma zona ou uma topologia de rede, está tomando decisões sobre:
- latência;
- disponibilidade;
- custo;
- residência de dados;
- raio de impacto de falhas;
- caminhos de entrada e saída;
- capacidade de recuperação.
É por isso que networking Cloud deveria ser aprendido antes da interface de qualquer provedor.
Os nomes mudam. O problema permanece:
onde o workload está, quem consegue alcançá-lo e o que acontece quando uma parte da infraestrutura deixa de funcionar?
Região: um limite geográfico e operacional
Os grandes provedores organizam infraestrutura em regiões geográficas.
Uma região costuma representar uma área suficientemente separada de outras regiões para funcionar como um domínio operacional relevante.
Escolher região afeta pelo menos quatro dimensões.
1. Latência
Quanto maior a distância física entre usuário e serviço, maior tende a ser a latência de rede.
Isso não significa que “a região mais próxima sempre vence”. Banco, integrações, CDN, edge e distribuição de usuários também influenciam.
2. Residência e governança de dados
Alguns workloads possuem requisitos regulatórios, contratuais ou internos sobre onde dados podem ser armazenados ou processados.
A região passa a fazer parte da arquitetura de compliance.
3. Disponibilidade de serviços
Nem todo produto ou feature existe em todas as regiões ao mesmo tempo.
Escolher uma região apenas por proximidade pode limitar serviços necessários ao projeto.
4. Blast radius
Falhas regionais são menos comuns do que falhas de uma instância ou zona, mas são possíveis.
Projetar múltiplas regiões reduz certos riscos e aumenta complexidade, custo, consistência de dados e operação.
Multi-region não deve ser reflexo. Deve responder a requisito concreto.
Zona: reduzir falhas correlacionadas dentro da região
Regiões são normalmente divididas em zonas de disponibilidade ou conceitos equivalentes.
AWS documenta Availability Zones como locais fisicamente separados dentro de uma região, com infraestrutura independente o suficiente para reduzir falhas correlacionadas. Google Cloud trata zonas como áreas de implantação dentro de uma região e recomenda múltiplas zonas para alta disponibilidade. Azure oferece zonas de disponibilidade em várias regiões e distingue recursos zonais de recursos com redundância entre zonas.
O conceito transferível é:
uma região
  ├─ zona A
  ├─ zona B
  └─ zona C
Se você coloca todas as instâncias na mesma zona, uma falha zonal pode atingir todas ao mesmo tempo.
Distribuir por zonas pode reduzir esse risco — mas apenas se o restante da arquitetura também tolerar a falha.
Não adianta ter três servidores em zonas diferentes e um único banco zonal sem réplica.
Também não adianta distribuir compute se a aplicação mantém sessão local ou depende de um volume que não pode ser montado na zona de failover.
Resiliência é propriedade do sistema, não do número de caixas desenhadas no diagrama.
Região e zona não significam exatamente a mesma coisa em todos os serviços
Um erro comum é assumir que todo recurso Cloud é “zonal”.
Alguns serviços são explicitamente zonais. Outros são regionais e já distribuem infraestrutura internamente. Outros ainda são globais.
Na AWS, EC2 é um exemplo clássico em que a instância pertence a uma Availability Zone, enquanto vários serviços gerenciados são regionais e usam múltiplas zonas por baixo.
No Google Cloud, VMs também são zonais, mas a VPC é global e suas subnets são regionais.
No Azure, Virtual Network e subnets atravessam as zonas da região; uma VM pode ser zonal sem que você precise criar uma VNet diferente para cada zona.
Essas diferenças importam porque “colocar em múltiplas zonas” pode significar configurações muito diferentes conforme o recurso.
Aprenda o escopo do conceito e depois confirme o escopo do produto específico.
Rede virtual: criar uma topologia lógica sobre infraestrutura compartilhada
Cloud pública é infraestrutura compartilhada entre muitos clientes.
Você precisa de uma forma de criar seu próprio espaço lógico de rede, endereçamento e regras de conectividade.
AWS chama isso de VPC. Azure usa Virtual Network, ou VNet. Google Cloud também usa VPC — com uma diferença importante: a VPC do Google é global, enquanto subnets são regionais.
O conceito comum é isolamento lógico.
Uma rede virtual permite organizar:
- faixas de endereços;
- sub-redes;
- rotas;
- regras de firewall;
- gateways;
- conectividade privada;
- endpoints internos e externos.
Isso se parece com uma rede física em vários aspectos, mas é programável e integrada ao control plane do provedor.
Subnet não deveria ser aprendida como “pública versus privada” primeiro
É comum encontrar tutoriais que começam dizendo: “crie uma subnet pública e outra privada”.
Esse rótulo é útil em alguns contextos — especialmente no vocabulário AWS — mas pode esconder o conceito.
Uma subnet é uma divisão do espaço de endereçamento e da topologia.
O que torna um recurso alcançável publicamente depende de combinação de fatores:
- possuir ou não endereço público;
- existir rota para Internet;
- gateway/NAT;
- regras de firewall;
- balanceador ou proxy na frente;
- política do serviço.
Por isso uma subnet chamada “privada” não é um escudo mágico.
E uma subnet “pública” não significa que todos os recursos nela precisem estar expostos.
O modelo mental melhor é perguntar qual caminho de conectividade existe entre origem e destino.
Endereço privado e endereço público
Um endereço privado é usado em um espaço de rede que não depende de roteamento público direto pela Internet.
Um endereço público permite participação em caminhos públicos, dependendo das demais regras.
Uma VM pode ter apenas IP privado e ainda acessar serviços externos através de NAT ou outro gateway.
Também pode receber tráfego externo indiretamente por um load balancer público que encaminha para seu endereço privado.
Essa separação é valiosa porque reduz a necessidade de expor cada servidor individualmente.
DNS: nomes desacoplam clientes de endereços
Endereços IP são úteis para roteamento. Nomes são mais úteis para contratos entre sistemas e usuários.
DNS permite mapear nomes para destinos que podem mudar ao longo do tempo.
Em Cloud isso se torna especialmente importante porque recursos podem ser substituídos, recriados ou distribuídos.
Você não quer que uma aplicação cliente dependa do IP efêmero de uma VM específica.
Um nome pode apontar para:
- endereço público;
- load balancer;
- serviço gerenciado;
- endpoint privado;
- outro nome.
Mas DNS não faz health check universalmente nem garante que o destino esteja saudável.
Alguns produtos de DNS e traffic management oferecem políticas avançadas, failover ou roteamento baseado em saúde; outros registros são apenas resolução de nome.
Novamente, o conceito vem antes do produto.
Ingress e egress: direção importa
Em networking Cloud, duas palavras aparecem o tempo todo:
- ingress: tráfego entrando numa fronteira ou recurso;
- egress: tráfego saindo.
Essa distinção importa por segurança, arquitetura e custo.
Um backend pode aceitar ingress apenas do load balancer, nunca diretamente da Internet.
Um banco pode aceitar ingress apenas da aplicação.
Um worker pode não aceitar tráfego externo algum, mas fazer egress para APIs de terceiros.
Egress também merece atenção porque vários provedores cobram certos tipos de transferência de saída, especialmente entre regiões ou para a Internet.
Isso significa que desenho de rede e desenho de custo podem se encontrar no mesmo fluxo.
NAT: acesso de saída sem exposição direta de entrada
Network Address Translation aparece frequentemente quando workloads privados precisam iniciar conexões para a Internet sem receber conexões públicas diretamente.
O detalhe de implementação varia por provedor.
O modelo mental é mais simples:
workload privado
      ↓ inicia conexão
gateway/NAT
      ↓
Internet

Internet
  ✕ conexão direta não solicitada
workload privado
NAT não substitui firewall, identidade ou proxy. Ele resolve uma parte do caminho de endereçamento/conectividade.
E pode virar ponto de custo ou dependência operacional dependendo da arquitetura e do provedor.
Load balancer: um ponto estável para múltiplos backends
Se você possui várias instâncias da aplicação, clientes não deveriam precisar saber qual delas atenderá cada requisição.
Um load balancer recebe tráfego e distribui entre backends conforme regras e saúde.
Isso pode ajudar a:
- remover instâncias não saudáveis;
- distribuir carga;
- esconder substituição de servidores;
- terminar TLS;
- rotear por hostname ou path;
- distribuir tráfego entre zonas ou regiões, dependendo do produto.
Google Cloud, por exemplo, oferece load balancers internos e externos, regionais e globais. AWS e Azure também possuem famílias com escopos e camadas diferentes.
Não existe um “load balancer universal”.
Alguns operam em camada 7 e entendem HTTP. Outros trabalham em camada 4 com TCP/UDP. Alguns são regionais; outros têm frontends globais.
Para aprender de forma transferível, comece pelas perguntas:
- qual tráfego entra?
- o frontend é público ou interno?
- onde estão os backends?
- como saúde é determinada?
- TLS termina onde?
- o roteamento precisa entender HTTP?
- a solução precisa atravessar regiões?
Depois escolha a implementação do provedor.
Load balancer não cria alta disponibilidade sozinho
Colocar um balanceador na frente de uma única VM muda pouco em termos de tolerância a falha da aplicação.
Mesmo com três backends, todos podem compartilhar o mesmo ponto de falha:
- mesma zona;
- mesmo banco;
- mesma dependência externa;
- mesma configuração quebrada;
- mesmo deploy defeituoso.
Balanceamento distribui tráfego. Resiliência depende da independência real entre os componentes que você espera usar como redundância.
Uma topologia simples e saudável
Para uma aplicação web tradicional, um desenho conceitual poderia ser:
Internet
   ↓
DNS
   ↓
load balancer público
   ↓
backends privados em mais de uma zona
   ↓
banco/serviço de dados
Isso não é uma receita universal.
É apenas um exemplo de separação entre borda pública e workloads que não precisam receber IP público individual.
Data residency: localização também pode ser requisito de negócio
Escolher região não é apenas otimização de latência.
Setores regulados, contratos e políticas internas podem exigir que determinados dados permaneçam em países ou áreas específicas.
Essa decisão pode afetar:
- onde bancos e storage são criados;
- para onde backups podem ser copiados;
- quais regiões participam de disaster recovery;
- onde logs e telemetry são armazenados;
- quais serviços gerenciados podem ser usados.
Um design multi-region tecnicamente elegante pode ser inadequado se replica dados para uma jurisdição não permitida.
Por isso requisitos de residência devem entrar antes da topologia, não depois.
Disponibilidade versus complexidade
Distribuir por zonas costuma ser um passo menor do que distribuir por regiões.
Multi-region adiciona desafios como:
- replicação de dados a maior distância;
- latência entre regiões;
- consistência;
- roteamento global;
- failover;
- deploy coordenado;
- duplicação de infraestrutura;
- custo;
- operação e testes de disaster recovery.
A AWS recomenda múltiplas zonas como base para workloads de produção quando o serviço e requisito permitem; múltiplas regiões entram quando a tolerância a falha regional realmente justifica a complexidade.
Azure faz a mesma distinção entre deployment local, zonal, zone-redundant e multi-region.
Google Cloud também diferencia topologias zonais, regionais, multirregionais e globais — com trade-offs de disponibilidade, custo e complexidade.
A conclusão não é “sempre use duas regiões”.
É: escolha o domínio de falha que seu requisito precisa tolerar.
Se o negócio suporta algumas horas de indisponibilidade diante de uma falha regional rara, uma arquitetura multi-region ativa pode não pagar seu custo.
Se o serviço é crítico e a região inteira precisa ser tolerada, então esse custo pode ser parte do requisito.
As diferenças entre AWS, Google Cloud e Azure importam
Aprender por conceitos não significa fingir que todos os provedores são iguais.
Algumas diferenças estruturais mudam o desenho.
AWS
Uma VPC pertence a uma região. Subnets são criadas em Availability Zones específicas.
Isso faz a relação entre rede e zona aparecer explicitamente na topologia.
Google Cloud
A VPC é global, enquanto subnets são regionais.
Uma única rede lógica pode atravessar regiões sem que você crie uma VPC separada para cada uma.
Isso é uma diferença importante em relação ao modelo AWS.
Azure
Uma Virtual Network é implantada numa região, mas suas subnets atravessam as availability zones daquela região.
Você não precisa dividir a VNet por zona apenas porque possui VMs zonais.
Essas diferenças são o motivo de evitar frases como:
“uma subnet sempre pertence a uma zona”.
Isso é verdadeiro em um contexto e falso em outro.
O conhecimento transferível é saber perguntar qual é o escopo de cada recurso: global, regional ou zonal.
Troubleshooting de rede começa pelo caminho
Quando uma aplicação Cloud “não conecta”, trocar regras aleatoriamente é um atalho ruim.
Reconstrua o caminho:
origem
  ↓
DNS
  ↓
rota
  ↓
firewall / policy
  ↓
gateway / NAT / load balancer
  ↓
endereço e porta do destino
  ↓
processo saudável?
Nem todas as conexões passam por todas essas camadas, mas o modelo ajuda a formular hipóteses.
Se DNS resolve para o destino errado, firewall não é a primeira pergunta.
Se a porta não está sendo escutada pelo processo, alterar route table não resolve.
Se uma VM privada não tem caminho de egress, a aplicação pode funcionar internamente e falhar apenas ao chamar APIs externas.
Networking deixa de parecer magia quando você investiga salto por salto.
O mapa mental que vale levar adiante
Quando você encontrar qualquer arquitetura Cloud, tente lê-la nesta ordem:
onde?
região / zona

quem se comunica?
rede / subnet / rota / DNS

quem pode entrar ou sair?
firewall / público / privado / ingress / egress

como o tráfego encontra backends saudáveis?
load balancer / health checks

o que acontece se uma parte falhar?
distribuição / redundância / failover
Esse raciocínio funciona mesmo quando os nomes dos produtos mudam.
No próximo estágio da série, a pergunta deixa de ser “onde e como conecta?” e passa a ser:
qual tipo de recurso devemos consumir — VM, storage, banco ou serviço gerenciado — e quanta operação queremos manter conosco?
É aí que compute, storage e managed services entram como escolhas de responsabilidade, não apenas como itens de catálogo.